
Health Check API SMM Panel Tanpa Membuat Order
Selain itu, health check API SMM panel sebaiknya memastikan integrasi dapat berkomunikasi tanpa membuat order nyata. Probe dapat memeriksa DNS, TLS, koneksi, autentikasi, latency, status code, bentuk respons, dan freshness data melalui operasi baca yang memang Anda dokumentasikan.
Singkatnya, membuat order kecil sebagai health check berisiko memotong saldo, mengubah target, memenuhi antrean, dan menghasilkan data palsu. Monitoring seharusnya mempunyai efek samping seminimal mungkin. Bila API tidak menyediakan operasi baca yang aman, gunakan pemeriksaan jaringan serta status internal dan eskalasi keterbatasannya.
Panduan ini editorial generik. Nama endpoint seperti balance, services, status, atau ping hanya boleh Anda pakai setelah muncul pada dokumentasi provider. Jangan menganggap BuzzerPanel atau API tertentu menyediakan endpoint, sandbox, atau header yang Anda sebut sebagai contoh.
Sebelum menyusun probe teknis, samakan pemahaman tim tentang order dan status melalui panduan lengkap SMM panel untuk pemula.
Apa yang sebenarnya ingin Anda ketahui?
“API hidup” terlalu kabur. Sebuah server dapat merespons, tetapi autentikasi gagal. Autentikasi dapat berhasil, tetapi schema berubah. Schema dapat benar, tetapi data sangat lama. Pecah health menjadi lapisan.
- Reachability: DNS dapat menyelesaikan hostname dan klien dapat membuat koneksi.
- Transport: TLS serta HTTP berjalan tanpa error kritis.
- Authentication: key masuk pada operasi aman.
- Contract: status dan bentuk respons sesuai ekspektasi.
- Freshness: data tidak melewati batas usia internal.
- Performance: latency berada dalam baseline.
Setiap lapisan menjawab pertanyaan berbeda. Dashboard perlu menunjukkan lapisan mana yang gagal agar operator tidak melakukan failover hanya karena satu label merah.
Liveness, readiness, dan dependency check
Liveness aplikasi Anda
Di sisi lain, liveness memastikan proses monitoring atau worker sendiri masih berjalan. Ia tidak perlu memanggil provider. Jika liveness gagal, masalah berada pada aplikasi Anda.
Readiness integrasi
Selain itu, readiness menilai apakah aplikasi siap menerima tugas. Ia dapat memeriksa konfigurasi tersedia, antrean dapat Anda akses, dan secret alias terpasang tanpa menampilkan value.
Dependency health
Selanjutnya, dependency check memanggil provider dengan operasi baca aman. Ini yang sering Anda sebut health provider. Jangan menggabungkan liveness dan dependency dalam satu endpoint internal karena gangguan provider dapat membuat orkestrator me-restart aplikasi yang sebenarnya sehat.
Pilih operasi tanpa efek samping
Urutan pilihan generik:
- Endpoint health resmi jika terdokumentasi.
- Selanjutnya, endpoint metadata atau katalog yang bersifat baca.
- Endpoint balance jika kontrak API mengizinkan operasi tersebut dan risikonya aman.
- Selain itu, status untuk remote order ID khusus monitoring yang sudah ada.
- Akhirnya, pemeriksaan HTTP/TLS tanpa autentikasi bila tidak ada operasi baca.
Jangan menebak method. HTTP mendefinisikan semantik method dan status dalam RFC 9110, tetapi API dapat menetapkan contract spesifik. HEAD tidak otomatis tersedia hanya karena GET ada.
Jangan gunakan create order
Endpoint create membawa efek finansial dan operasional. Quantity nol atau target palsu juga bukan health check; request tersebut bisa berakhir dengan penolakan, masuk log, atau mengganggu metrik. Gunakan test environment hanya jika provider secara resmi menyediakannya.
Health check API SMM panel dalam tiga tingkat
Tingkat 1: network probe
Setelah itu, ukur DNS, koneksi TCP, TLS, dan waktu respons HTTP. Tidak perlu key. Probe ini menunjukkan jalur jaringan, bukan fungsi aplikasi.
Tingkat 2: authenticated read
Panggil operasi baca yang Anda dokumentasikan dengan key monitoring terbatas bila tersedia. Validasi status code dan response body tanpa mencatat secret.
Tingkat 3: contract probe
Karena itu, periksa field wajib, tipe data, serta nilai masuk akal. Jangan menolak seluruh provider hanya karena field opsional baru. Parser harus toleran terhadap penambahan field dan tegas pada field inti.
| Tingkat | Apa yang Anda uji | Efek samping |
|---|---|---|
| Network | DNS, TLS, HTTP | Tidak ada perubahan bisnis |
| Authenticated read | Key dan operasi baca | Quota/log mungkin bertambah |
| Contract | Schema dan freshness | Parsing internal |
Interval probe: jangan membuat monitoring menjadi gangguan
Sementara itu, probe terlalu sering dapat menghabiskan quota, memicu rate limit, dan membanjiri log. Probe terlalu jarang memperlambat deteksi. Tentukan interval dari risiko, baseline, dan dokumentasi provider.
Tambahkan jitter agar semua worker tidak menembak pada detik sama. Gunakan satu service monitoring terpusat, bukan setiap request pelanggan menjalankan health check penuh.
Adaptive interval
Namun, saat HEALTHY, interval dapat lebih longgar. Saat DEGRADED, frekuensi dapat meningkat secara terbatas untuk konfirmasi. Saat UNHEALTHY, backoff mencegah hammering. Tetapkan batas maksimum dan minimum internal.
Metrik yang Anda kumpulkan
- Timestamp dan zona waktu.
- Provider serta endpoint alias.
- DNS/TLS/connect latency.
- Time to first byte dan total latency.
- Status code atau kategori error.
- Schema validation result.
- Freshness data jika ada timestamp.
- Correlation ID.
Selain itu, Google SRE menyarankan memperhatikan latency, traffic, errors, dan saturation dalam pemantauan sistem tersebar. Pilih metrik yang dapat Anda tindaklanjuti untuk integrasi Anda.
Validasi respons tanpa overfitting
Meski begitu, jangan membandingkan JSON sebagai string utuh. Urutan field dan whitespace dapat berubah. Parse respons, lalu periksa field inti serta tipe. Simpan schema version internal.
Contoh generik, bukan schema provider:
{
  "ok": true,
  "data": { "kind": "read-only-result" }
}
Selanjutnya, parser tidak boleh menampilkan body mentah kepada pengguna bila mengandung saldo atau informasi akun. Masking dan retensi log mengikuti kebutuhan.
Ingin mendeteksi gangguan tanpa membuat order percobaan?
Mulai dari operasi baca yang terdokumentasi, log aman, dan state health yang dapat tim jelaskan saat alert muncul.
Petakan Health Check IntegrasiState health: hindari keputusan biner
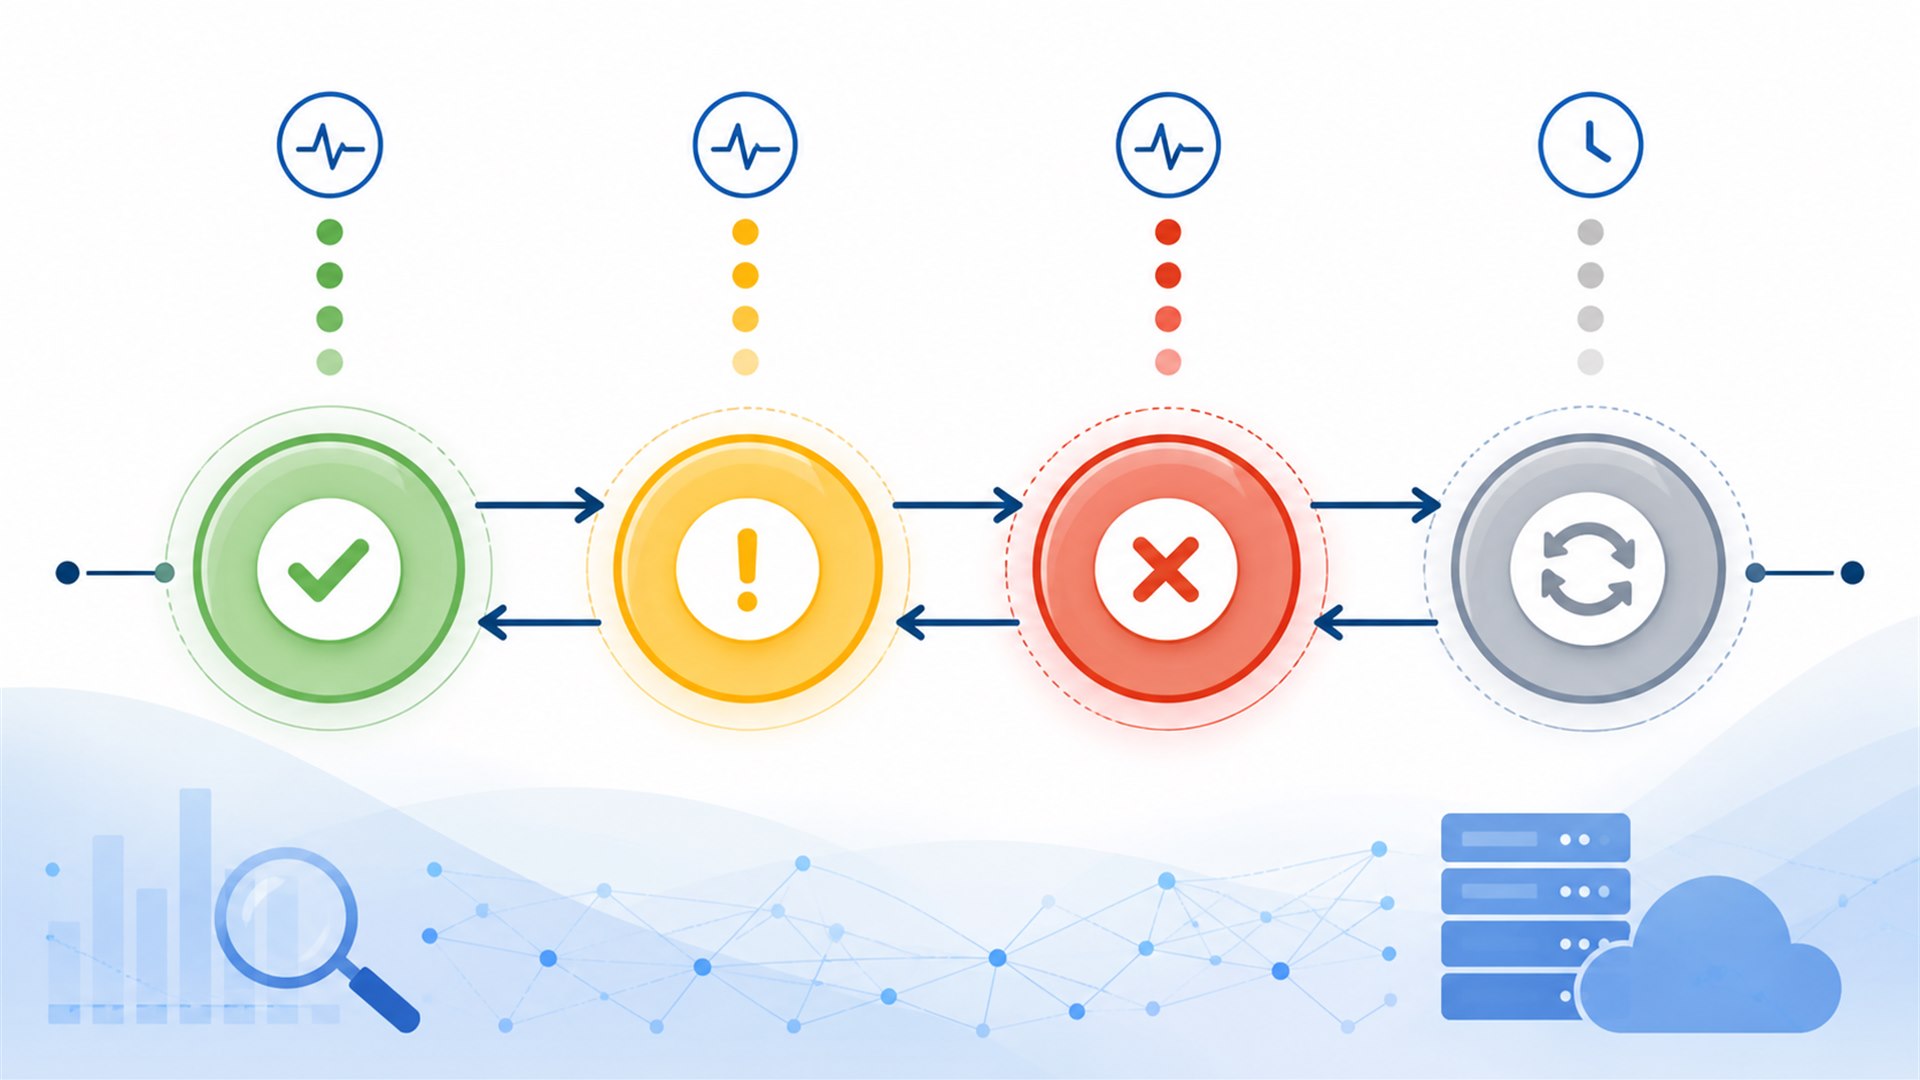
- HEALTHY: beberapa probe berhasil dan contract valid.
- DEGRADED: latency tinggi, error sporadis, atau freshness menurun.
- UNHEALTHY: kegagalan berulang melewati ambang internal.
- UNKNOWN: belum cukup data atau monitoring sendiri bermasalah.
Sementara itu, satu timeout memindahkan ke kandidat DEGRADED, bukan langsung UNHEALTHY. Gunakan consecutive failures dan recovery successes. Simpan alasan transisi.
Hysteresis
Gunakan ambang berbeda untuk turun dan pulih. Misalnya, butuh beberapa kegagalan untuk UNHEALTHY dan beberapa keberhasilan untuk HEALTHY. Tentukan angka spesifik dari sistem Anda, bukan artikel.
Pseudocode probe generik
function probe(provider):
    start = monotonic_time()
    response = call_documented_read_operation(provider)
    latency = monotonic_time() - start

    if network_error:
        return result("network_error", latency)

    if authentication_error:
        return result("auth_error", latency)

    if !contract_is_valid(response):
        return result("contract_error", latency)

    return result("ok", latency)
Selanjutnya, implementasi nyata perlu timeout, cancellation, TLS validation, secret management, dan masking. Jangan menyalin pseudocode sebagai kode produksi.
Timeout dan retry
Sementara itu, timeout probe harus lebih pendek dari interval dan tidak menumpuk. Jika request lama belum selesai, jangan memulai banyak probe baru. Gunakan cancellation atau single-flight.
Kemudian, retry hanya untuk konfirmasi terbatas dan memakai backoff plus jitter. Error autentikasi atau contract biasanya tidak membaik dengan retry cepat. Klasifikasikan error terlebih dahulu.
Circuit breaker
Ketika kegagalan berulang, circuit breaker menghentikan request sementara. Probe ringan dapat berjalan pada state half-open untuk menguji pemulihan. Jangan gunakan order nyata sebagai half-open test.
Key khusus monitoring
Namun, jika provider mendukung beberapa key dan scope, gunakan key read-only khusus monitoring. Jangan memakai key produksi create-order bila tidak perlu. Jika tidak ada pembatasan, dokumentasikan risikonya.
Selanjutnya, key tidak boleh masuk URL, log, metric label, atau alert. Gunakan alias. Rotasi monitoring key dan uji bahwa key lama tidak lagi masuk.
Dashboard yang berguna bagi operator
Sementara itu, tampilkan state, alasan, latency terakhir, success rate, waktu probe, waktu perubahan state, dan link runbook. Jangan hanya menampilkan lampu hijau-merah.
Selanjutnya, grafik latency membantu membedakan lonjakan sementara dari tren. Kelompokkan error menjadi network, auth, rate limit, server, contract, dan internal monitoring.
Hindari cardinality tinggi
Jangan memakai target, Order ID, atau pesan error mentah sebagai label metric. Jumlah label dapat meledak. Simpan detail pada log dengan correlation ID.
Alert yang dapat Anda tindaklanjuti
Selanjutnya, alert harus menjawab apa yang gagal, sejak kapan, provider mana, dampak, dan runbook. Jangan mengirim alert pada setiap probe gagal jika state belum berubah.
Gunakan severity berbeda. DEGRADED dapat menjadi peringatan. UNHEALTHY pada provider utama dapat meminta tindakan. UNKNOWN pada monitoring sendiri membutuhkan pemeriksaan berbeda.
Dedup dan silence
Gabungkan alert berulang. Saat maintenance terjadwal, silence harus memiliki batas waktu dan pemilik. Jangan mematikan alert tanpa catatan.
Runbook saat health berubah
- Periksa apakah monitoring sendiri sehat.
- Setelah itu, lihat error class dan beberapa probe terakhir.
- Karena itu, bandingkan dengan pengumuman provider.
- Selanjutnya, periksa operasi baca manual dari lingkungan terkontrol.
- Bekukan create baru jika risiko tinggi.
- Selain itu, jangan retry order UNKNOWN.
- Ikuti gate failover jika ada.
- Dokumentasikan keputusan dan waktu.
Pengujian monitoring
DNS gagal
Setelah itu, pastikan Anda mengelompokkan hasilnya sebagai gangguan network tanpa membocorkan key.
TLS tidak valid
Sementara itu, probe harus gagal tertutup. Jangan menonaktifkan verifikasi sertifikat untuk membuat lampu hijau.
401/403
Klasifikasikan auth. Cek key alias, rotasi, dan scope. Jangan retry cepat dengan key sama.
429
Klasifikasikan rate limit. Kurangi frekuensi dan ikuti petunjuk resmi bila ada. Jangan menambah worker.
Schema berubah
Sementara itu, field inti hilang harus memberi contract error. Field tambahan sebaiknya tidak mematahkan parser.
Monitoring mati
State provider menjadi UNKNOWN, bukan UNHEALTHY. Alert liveness monitoring.
Dokumentasi contract
Simpan method, endpoint alias, auth method, field inti, timeout, interval, rate limit, dan owner. Jangan menaruh key. Tautkan ke dokumentasi sumber serta tanggal pemeriksaan.
Selain itu, artikel API SMM panel standar memberi gambaran istilah umum. Implementasi wajib mengikuti contract provider yang benar-benar Anda pakai.
Health check untuk multi-provider
Selanjutnya, jalankan probe terpisah dan hindari menyinkronkan waktunya. Simpan health global serta per layanan jika data tersedia. Provider dapat sehat sementara satu service maintenance.
Meski begitu, jangan merutekan order hanya dari health global. Validasi mapping, rate, quantity, dan status order lama. Monitoring memberi sinyal, bukan keputusan lengkap.
SOP reseller non-teknis
Selain itu, operator tidak harus membaca log teknis. Sediakan ringkasan: state, dampak, tindakan, dan waktu cek berikutnya. Developer menangani error class dan contract.
Untuk dasar bisnis serta alur pelanggan, baca panduan reseller SMM panel Indonesia. Monitoring mendukung operasi, bukan menggantikan dukungan.
Pisahkan kesehatan teknis dan kualitas layanan
Jadi, API yang merespons cepat belum tentu berarti semua order berjalan sesuai estimasi. Sebaliknya, satu layanan maintenance tidak selalu berarti autentikasi dan status order lain gagal. Buat dua kelompok sinyal: kesehatan integrasi teknis dan kualitas bisnis layanan.
Kemudian, sinyal teknis mencakup DNS, TLS, koneksi, autentikasi, schema, latency, dan rate limit. Sinyal bisnis mencakup start time historis, completion, partial, serta komplain. Jangan mencampur keduanya menjadi satu lampu hijau.
Singkatnya, health check hanya memberi jawaban sempit: apakah dependency dapat Anda gunakan untuk operasi tertentu saat ini. Penilaian kualitas memerlukan data order nyata yang terjadi secara alami, bukan order sintetis berulang.
Matriks pemilihan probe read-only
| Kandidat probe | Kelebihan | Risiko yang Anda periksa |
|---|---|---|
| Endpoint health resmi | Ringan dan jelas bila tersedia | Mungkin tidak menguji autentikasi |
| Daftar layanan | Menguji auth dan schema katalog | Payload dapat besar atau Anda batasi |
| Saldo | Menguji auth serta field numerik | Informasi sensitif di log |
| Status order lama milik sendiri | Menguji pemetaan order | ID harus valid dan tetap dapat Anda baca |
| Endpoint publik | Menguji jaringan dasar | Tidak membuktikan API privat sehat |
Setelah itu, pilih kandidat yang terdokumentasi, tidak mengubah state, dan biayanya rendah. Bila provider tidak menjamin endpoint tertentu stabil, jangan menjadikannya satu-satunya probe.
Lokasi probe memengaruhi hasil
Kemudian, probe dari laptop operator tidak mewakili server produksi. Perbedaan DNS, firewall, IP allowlist, rute, dan zona dapat menghasilkan kondisi berbeda. Jalankan probe utama dari lingkungan yang benar-benar melakukan request bisnis.
Probe kedua dari lokasi lain berguna untuk membedakan gangguan lokal dan global. Namun, jangan menggabungkan hasilnya tanpa label. “Sehat dari lokasi A, gagal dari lokasi B” lebih informatif daripada rata-rata hijau.
Simpan region atau identitas runner sebagai label berjumlah kecil. Jangan memakai hostname ephemeral sebagai label metrik jika membuat kardinalitas meledak.
DNS, TLS, dan waktu sistem perlu Anda periksa terpisah
Selain itu, kesalahan jaringan sering muncul sebagai timeout umum. Ukur tahap resolusi DNS, pembukaan koneksi, negosiasi TLS, time to first byte, dan waktu membaca body bila library memungkinkan.
Karena itu, catat sisa masa berlaku sertifikat tanpa menonaktifkan validasi. Jangan menjadikan opsi “skip TLS verify” sebagai solusi monitoring. Jika sertifikat tidak valid, state harus menunjukkan gangguan keamanan.
Selanjutnya, sinkronisasi waktu server juga penting untuk request yang memakai timestamp atau signature. Clock drift dapat terlihat seperti autentikasi gagal. Monitor waktu sistem melalui mekanisme infrastruktur, bukan dengan mengarang timestamp dari respons provider.
Validasi semantik, bukan hanya status 200
Proxy atau halaman maintenance dapat membalas 200 dengan HTML. Probe perlu memeriksa content type bila contract menetapkannya, JSON valid, field inti, tipe data, dan batas ukuran respons.
Namun, jangan menuntut urutan field atau field opsional tanpa jaminan dari contract. Buat parser health cukup ketat untuk mendeteksi respons salah tetapi cukup fleksibel terhadap tambahan field yang kompatibel.
Setelah itu, simpan hash schema atau versi parser yang Anda gunakan. Jika contract berubah, operator dapat menghubungkan alert dengan deployment atau perubahan provider.
Maintenance terencana bukan kondisi yang sama dengan down
Namun, bila provider menyediakan informasi maintenance melalui kanal resmi, operator dapat menandai state MAINTENANCE beserta waktu mulai dan perkiraan selesai. Jangan mengarang jadwal dari satu error.
Selama maintenance, kurangi probe agar tidak menambah beban, tetapi jangan mematikannya total. Probe kecil memastikan pemulihan terdeteksi. Alert dapat Anda arahkan berbeda agar tim tidak menerima notifikasi duplikat.
Setelah jendela selesai, state tidak langsung menjadi healthy hanya berdasarkan kalender. Tunggu probe sukses sesuai ambang pemulihan.
SLO monitoring dan error budget
Tentukan target internal untuk kesiapan integrasi, misalnya persentase probe sukses dan batas latency dalam periode tertentu. Sesuaikan angkanya dengan kebutuhan bisnis; tidak ada target universal.
Error budget membantu membedakan gangguan sesaat dan pola berulang. Jika budget cepat habis, tunda perubahan berisiko dan perbaiki reliability. Jangan memanipulasi hasil dengan memperjarang probe hanya agar persentase terlihat baik.
Laporkan ketidakpastian. Jika runner mati atau data hilang, status observability adalah unknown. Ketiadaan data bukan keberhasilan.
Deteksi blind spot pada sistem monitoring
Monitoring juga merupakan dependency. Buat heartbeat runner, umur sampel terakhir, keberhasilan menulis metrik, dan keberhasilan jalur alert. Dashboard harus menampilkan waktu terakhir sistem memperbarui data.
Karena itu, uji alert secara berkala dengan sinyal sintetis internal, bukan dengan mematikan provider. Pastikan notifikasi sampai ke kanal yang masih aktif dan runbook dapat Anda buka.
Namun, jika semua provider tiba-tiba terlihat sehat dengan latency nol, curigai pipeline metrik. Nilai nol dan nilai tidak ada harus Anda bedakan.
Checklist go-live health check API SMM panel
- Endpoint probe terverifikasi read-only dan terdokumentasi.
- Runner berada di lingkungan yang mewakili produksi.
- Timeout, interval, retry, dan jitter mempunyai batas.
- Sementara itu, validasi respons berdasarkan status, format, dan field inti.
- Key monitoring memiliki akses minimum.
- Kemudian, state healthy, degraded, unhealthy, maintenance, dan unknown jelas.
- Hysteresis mencegah flapping.
- Selain itu, metrik tidak menyimpan key atau data sensitif.
- Alert mempunyai dampak, owner, serta runbook.
- Runner dan jalur alert ikut dipantau.
Sementara itu, setelah aktif, tinjau false positive, false negative, dan biaya request. Monitoring yang baik terus Anda kalibrasi berdasarkan bukti operasional.
Contoh laporan shift yang ringkas
Laporan operator dapat berisi state sekarang, waktu perubahan, endpoint alias yang Anda periksa, latency p95, error class dominan, antrean terdampak, tindakan, dan waktu evaluasi berikutnya. Hindari menyalin respons mentah.
Selain itu, contoh narasi: “Provider A degraded sejak 10.15 WIB; authenticated read berhasil tetapi latency p95 naik. Tim menahan create order pada layanan tertentu dan tetap memantau status order lama dengan interval lebih panjang. Evaluasi berikutnya 10.30 WIB.”
Narasi itu membedakan fakta, dampak, dan tindakan. Ia tidak menyimpulkan semua layanan gagal hanya dari satu sinyal.
Tinjau probe setelah perubahan API
Kemudian, setiap perubahan endpoint, autentikasi, schema, atau jaringan memerlukan review probe. Jalankan versi lama dan baru berdampingan dalam waktu terbatas, bandingkan hasilnya, lalu pindahkan alert setelah data stabil. Jangan menghapus metrik lama sebelum operator dapat menghubungkan perubahan state dengan migrasi tersebut.
FAQ health check
Apakah health check harus membuat order?
Tidak. Gunakan endpoint health atau operasi baca yang Anda dokumentasikan. Jika tidak ada, periksa jaringan dan contract yang aman.
Bolehkah memakai target palsu?
Jangan. Request create tetap dapat masuk log, antrean, atau memotong saldo. Gunakan sandbox hanya bila provider resmi menyediakannya.
Berapa interval yang tepat?
Tergantung quota, risiko, baseline, dan dokumentasi. Tambahkan jitter, backoff, dan batas agar monitoring tidak menjadi beban.
Apakah satu timeout berarti down?
Tidak. Gunakan beberapa probe, error classification, dan hysteresis. Satu timeout biasanya menandai degradasi untuk konfirmasi.
Apa yang harus masuk dashboard?
Selanjutnya, state, alasan, latency, success rate, waktu probe, transisi terakhir, dan runbook. Jangan tampilkan key atau payload sensitif.
Kesimpulan
Health check API SMM panel yang baik tidak membuat order. Ia menguji lapisan network, transport, auth, contract, freshness, dan performance melalui operasi baca yang terdokumentasi.
Setelah itu, gunakan state HEALTHY, DEGRADED, UNHEALTHY, dan UNKNOWN; tambah retry terbatas, backoff, monitoring key, dashboard, alert, serta runbook. Verifikasi seluruh endpoint pada dokumentasi provider.
Monitoring sudah bisa membedakan lambat, gagal autentikasi, dan down?
Cocokkan operasi baca serta batasannya dengan dokumentasi akun, lalu uji alert dan runbook pada lingkungan berisiko rendah.
Cocokkan Operasi Monitoring